王亦洲课题组 ICLR 2026 入选论文解读:交互的两个大模型,内部表征会“同步”?
导 读
当两个人面对面交谈、共同演奏或合作完成一项任务时,他们的大脑活动往往会逐渐呈现出相似的时间节律。这一现象被称为脑间同步(Inter-brain Synchrony,IBS)。越来越多的神经科学研究发现,脑间同步不仅与共同的感官输入有关,还可能反映互动双方对彼此心理状态的持续理解、预测与适应。如今,大语言模型(Large Language Model,LLM)已经能够在谈判、合作、竞争和说服等场景中开展复杂的社会互动。那么,当两个 LLM 持续交流时,它们的内部神经表征之间是否也会形成类似的“同步”?这种同步究竟只是因为双方共享部分相同的对话历史,还是来自对彼此状态的动态建模?更进一步地,它是否与模型的社会交互能力有关?
这篇发表于机器学习领域顶会 ICLR 2026 的研究论文 Neural Synchrony Between Socially Interacting Language Models 探索了这些问题。该研究由北京大学王亦洲课题组、宁波东方理工大学朱文韬助理教授和伊利诺伊大学厄巴纳-香槟分校 Blender 实验室合作完成。
01
背景介绍
在真实的社会互动中,我们不仅需要理解对方已经表达的信息,还需要持续推测对方的目标、情绪与下一步行动,并根据这些判断及时调整自己的行为。神经科学研究发现,这一过程可能在不同个体的大脑之间留下可测量的痕迹:当人们进行对话、共同注意或合作完成任务时,他们的神经活动会出现时间上的协同。研究者通常使用超扫描(Hyperscanning)技术同时记录多个个体的大脑活动,并分析其神经信号之间的动态耦合。
值得注意的是,脑间同步并不只是相同声音或画面所造成的被动响应。在一些缺少直接感官交换的合作任务中,研究者同样观察到了这一现象;它的强度还会随着合作程度、关系亲近性和团队表现而变化。这些发现表明,社会认知并非完全局限于单个个体内部,也可能体现在互动双方如何逐步建立共同的动态结构。
近期,大语言模型开始被广泛用于多智能体社会模拟。已有研究主要从行为层面评价模型能否完成谈判、合作或说服任务,以及它们是否具备理解他人信念和意图的心智理论(Theory of Mind,ToM)能力。然而,我们对社会互动过程中多个模型内部表征如何相互影响仍然知之甚少。
基于上述背景,我们提出了两个核心研究问题:首先,在持续的社会互动中,一个 LLM 的内部表征能否预测另一个 LLM 的表征,并表现出类似脑间同步的动态联系?其次,如果这种联系确实存在,它是否能够反映模型的社会交互能力,并帮助我们理解多智能体社会推理的内部机制?
02
测量大语言模型间的神经同步
为了研究上述问题,我们首先在 SOTOPIA 社会模拟环境中构建了双智能体互动。两个 LLM 分别扮演具有不同背景、性格、秘密和社会目标的角色,并在谈判、合作、竞争和说服等场景中展开多轮交流。例如,一个角色希望以 400 美元以上卖出电视,另一个角色则希望以不超过 450 美元的价格买下它。双方拥有各自的私人信息和目标,并根据不断更新的对话历史决定下一步行动。
我们选取 Mistral 与 Llama 两个模型家族中的 6 个开源模型,共组成 21 个模型组合,并在 3 个随机种子下模拟 450 个互动场景。每段互动最多持续 8 轮。对于每一轮对话,我们提取模型各层最后一个输入标记(Token)的隐藏状态(Hidden State),其中同时整合了角色设定、私人目标和此前的对话信息,可以作为模型在当前互动时刻的内部表征。
接下来,我们使用一个简单的线性映射,尝试根据智能体 A 当前时刻的内部表征,预测智能体 B 下一时刻的内部表征。具体而言,我们在 A 与 B 的每一对网络层之间训练带截距的岭回归(Ridge Regression),并在未经训练的样本上评估计算决定系数 R2。如果 A 的内部状态包含了对 B 的目标、情绪或后续反应的有效预测,那么它应当能够解释 B 表征中的一部分变化,得到大于 0 的测试集决定系数。
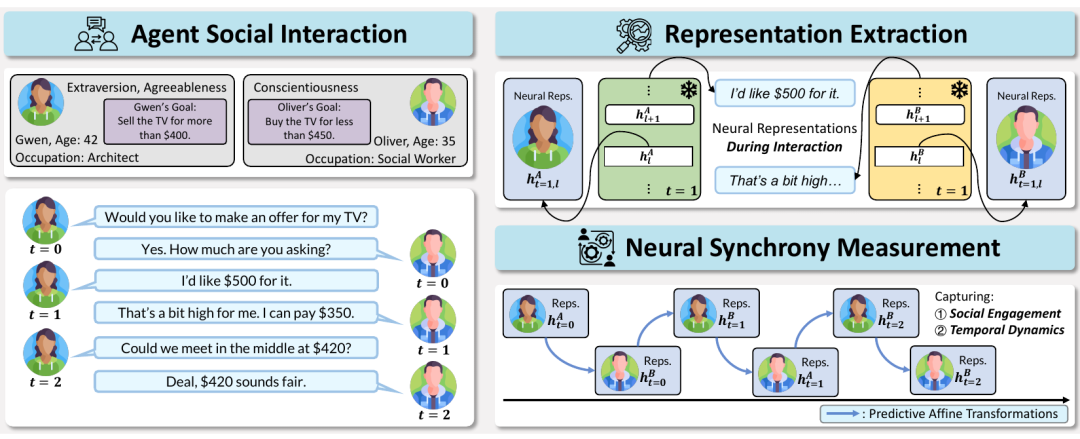
图1. 论文 Figure 1:从社会互动、内部表征提取到神经同步测量的整体框架。
hB(t+1, m) ≈ W(ℓ, m) hA(t, ℓ) + b(ℓ, m)
即:A 此刻的内部状态,能在多大程度上解释 B 接下来的内部状态?
需要指出的是,这里的同步并不是直接比较两个表征向量是否相似。由于两个智能体具有不同的角色、目标和输入,它们的内部状态本身并不需要保持一致。我们关注的是,一个模型的当前表征是否包含足以预测另一个模型后续表征的信息,因此测量的是互动过程中跨智能体的动态可预测性。
具体而言,对于 A 的每一层,我们保留其在 B 中预测效果最好的目标层,将负的 R2 截断为 0,并在所有源层上取平均;随后交换预测方向,再对 A→B 与 B→A 的结果取平均,得到最终的神经同步指标 SyncR2。SyncR2 越高,说明两个模型在互动过程中形成了越强的表征耦合。
03
神经同步捕捉真实的社会互动
尽管上述方法能够测量两个模型之间的表征可预测性,但这种可预测性也可能来自双方共享的对话文本,或模型之间相对稳定的表征结构。为了验证 SyncR2 是否真正捕捉了社会互动中的动态联系,我们进一步设计了两组控制实验。
社会参与 (Social Engagement)控制实验
在正常设置中,两个智能体都需要根据各自的角色和目标生成回复。作为对照,我们让其中一个模型成为“被动读者”:它仍然接收相同的背景与对话历史,但不再获得生成回复的指令,也不实际参与互动。这样便可以在保持文本输入基本一致的情况下,单独考察社会参与的作用。
时间错位 (Temporal Proximity) 控制实验
我们还将原本时间相邻的表征进行错位,使用 A 当前的表征预测 B 更远时刻的表征。如果 SyncR2 反映的是互动过程中实时形成的耦合关系,那么随着时间间隔增大,表征之间的可预测性应当逐渐减弱。
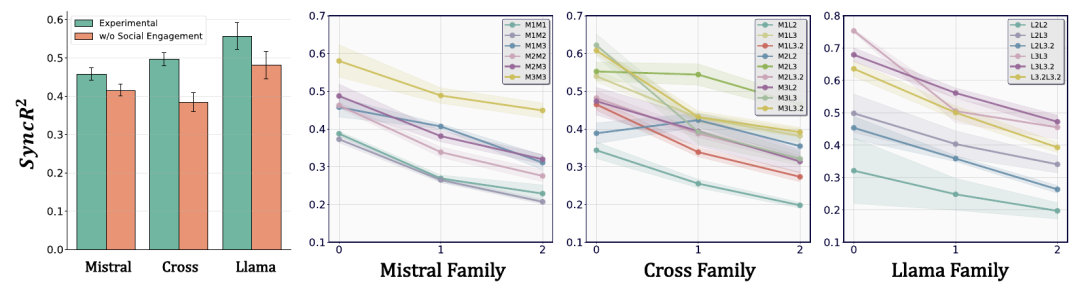
图2. 论文 Figure 4:缺少社会参与时,平均SyncR2 明显下降;将表征错开 1 至 2 个时间步后,同步性也随之减弱。
发现1:当一个模型只被动阅读对话时,Mistral、Llama 以及跨模型家族组合的平均 SyncR2 均明显下降。这一结果表明,仅仅接收相同的对话内容不足以产生同等程度的神经同步,主动参与社会互动是其中的重要条件。
发现2:当两个模型的表征在时间上错开 1 至 2 个时间步后,绝大多数模型组合的同步性迅速减弱。这说明 SyncR2 并非模型结构所决定的静态相似性,而是与互动双方在同一时刻的社会状态密切相关。
我们进一步考察了角色关系对同步程度的影响。随着关系从陌生人、仅知道姓名、熟人、朋友到浪漫关系逐渐亲近,SyncR2 的整体分布呈现出逐步上移的趋势。这一观察与人类脑间同步研究中的相关发现相呼应,也表明该指标能够反映互动场景中的社会关系结构。
04
神经同步与社会表现
上述结果说明,两个 LLM 在社会互动中会形成具有参与依赖性和时间特异性的表征同步。接下来,我们进一步研究这种同步是否与模型的社会交互能力有关。为此,我们使用 SOTOPIA-EVAL 对 21 个模型组合进行多维度评价,涵盖目标完成、关系影响和角色可信度等指标,并对每个组合在不同随机种子下的结果取平均。
我们发现,在三个模型组中,SyncR2 与社会表现均呈现显著的正相关。Mistral 家族模型组合的 Pearson 相关系数 r 为 0.88,跨模型家族组合为 0.89,Llama 家族模型组合达到 0.99。也就是说,内部状态越能够相互预测的模型组合,通常也能在社会任务中取得更好的表现。
一个可能的解释是,能力更强的模型既更擅长遵循指令和处理长上下文,也同时获得了更高的 SyncR2 与社会得分。为了排除这一混淆,我们分别使用 IFEval 和 MuSR 控制模型的指令遵循与长上下文推理能力。结果表明,在控制这些一般能力后,三个模型组中的偏相关仍然全部为正,并且大多数依然较强。这些结果说明,神经同步与社会表现之间的联系不能被一般模型能力完全解释。
为什么一个智能体的当前表征能够预测另一个智能体接下来的表征?一种可能的解释来自心智理论(Theory of Mind,ToM)。在互动过程中,模型不仅需要处理对方已经说出的内容,还需要追踪其可能持有的信念、目标、情绪与意图。当两个模型同时对彼此的心理状态进行建模时,它们的内部表征便可能形成结构化的耦合。
另一种解释来自社会预测编码(Social Predictive Coding)。社会互动本身是一个不断预测并修正的过程:对方下一步会接受、拒绝、让步,还是改变情绪?如果模型在当前表征中持续预测互动的发展,那么一个模型的状态自然会包含另一个模型未来状态的信息。
为了初步检验上述解释,我们在附加实验中要求智能体显式输出自身的情绪与行动类型,同时将这些标签从对方可见的对话历史中删除。我们发现,一个智能体的隐藏表征不仅能够解码对方此前的情绪,还包含了对方未来情绪的预测信息;相比之下,对未来行动的解码仅略高于随机水平。这些观察进一步表明,模型可能在互动过程中持续追踪并预测他人的社会状态。
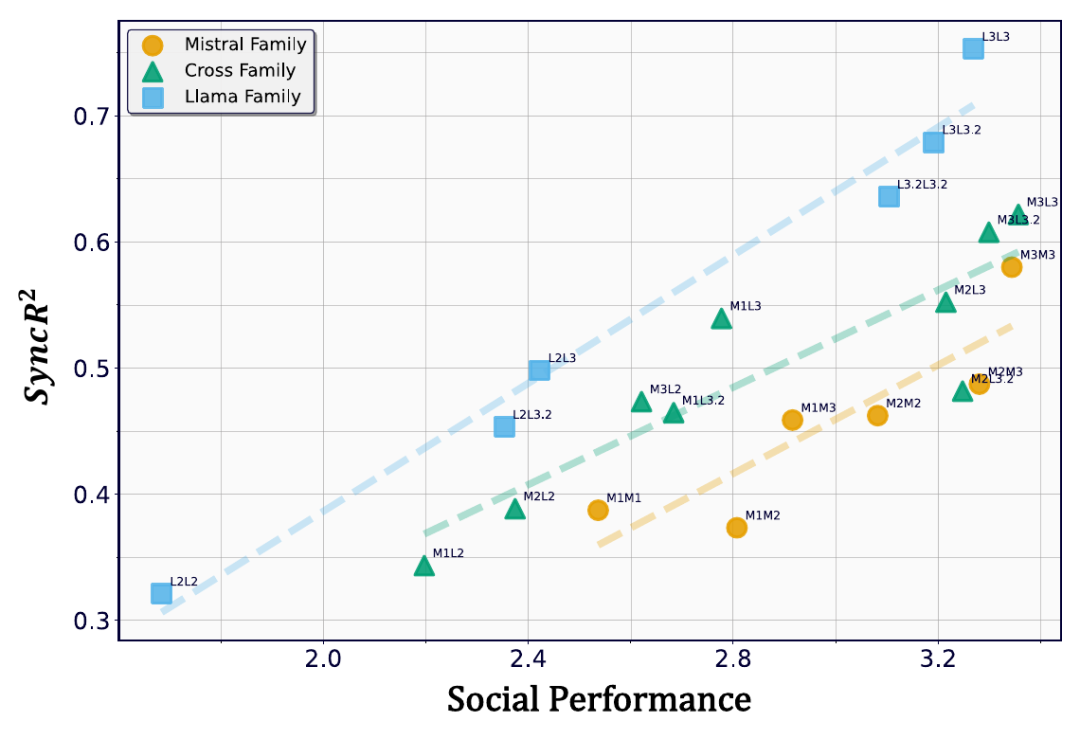
图3. 论文 Figure 6:在 Mistral 家族、Llama 家族与跨家族模型组合中,SyncR2 均与社会表现呈明显正相关。
05
总结与展望
在这项工作中,我们从表征的视角研究了社会互动中的两个大语言模型,并提出 SyncR2 来测量不同智能体内部状态之间的动态可预测性。我们的实验表明,这种神经同步依赖于双方的主动社会参与和时间对齐,并会随着角色关系的亲近而增强。进一步地,在 21 个模型组合中,神经同步程度与行为层面的社会表现呈现出显著正相关。
这些发现为理解多智能体系统中的社会认知提供了一个新的分析视角。过去,我们通常通过模型最终说了什么、任务是否完成来评价其社会能力;而这项工作表明,不同模型在互动过程中如何形成跨智能体的内部表征联系,同样可能是理解社会智能的重要线索。
需要指出的是,本文中的“神经同步”是一种受脑间同步启发的表征类比,并不意味着 LLM 具有生物神经活动或人类意识。此外,当前结果揭示的是稳定的相关关系,尚不能确定同步与社会表现之间的因果方向;实验也主要集中于 6 个开源模型、最多 8 轮的双智能体文本互动,社会表现主要由自动评估器衡量。展望未来,通过对同步相关表征进行定向干预,并将研究扩展到更长期的交流、多人协作、人机互动与具身场景,有望进一步揭示表征同步在机器社会智能中的功能性作用。